เราเคยเรียนแล้วว่า Context Window คือพื้นที่ทำงานของ AI ใน บทที่ 3 เรียนวิธีย่อ ล้าง และส่งต่องานใน บทที่ 29 และเรียนการดูค่าใช้จ่ายรวมกับตั้ง Budget alert ใน บทที่ 49
บทนี้ต่อยอดอีกขั้น: ก่อนเรียกโมเดลหนึ่งครั้ง เราจะรู้ได้อย่างไรว่ากำลังส่งอะไรเข้าไป หลังจบงานจะอ่าน Usage อย่างไร และจะลดต้นทุนโดยไม่ตัดข้อมูลสำคัญได้ตรงไหน
เป้าหมายไม่ใช่ Token ต่ำที่สุด แต่คือ Token ที่พอดีกับงานและให้ผลลัพธ์ผ่าน Gate
บทนี้เน้นงานผ่าน API หรือ Agent ที่อ่าน Usage ต่อ Request ได้ หากใช้แอปแชตแบบ Subscription ให้ใช้หลักเรื่อง Context และคุณภาพได้ แต่ไม่ควรนำสูตร API ไปคูณแทนเงื่อนไขของแพ็กเกจแชต
สไลด์ 1 — Token ไม่ได้มีแค่เรื่องแชทยาว
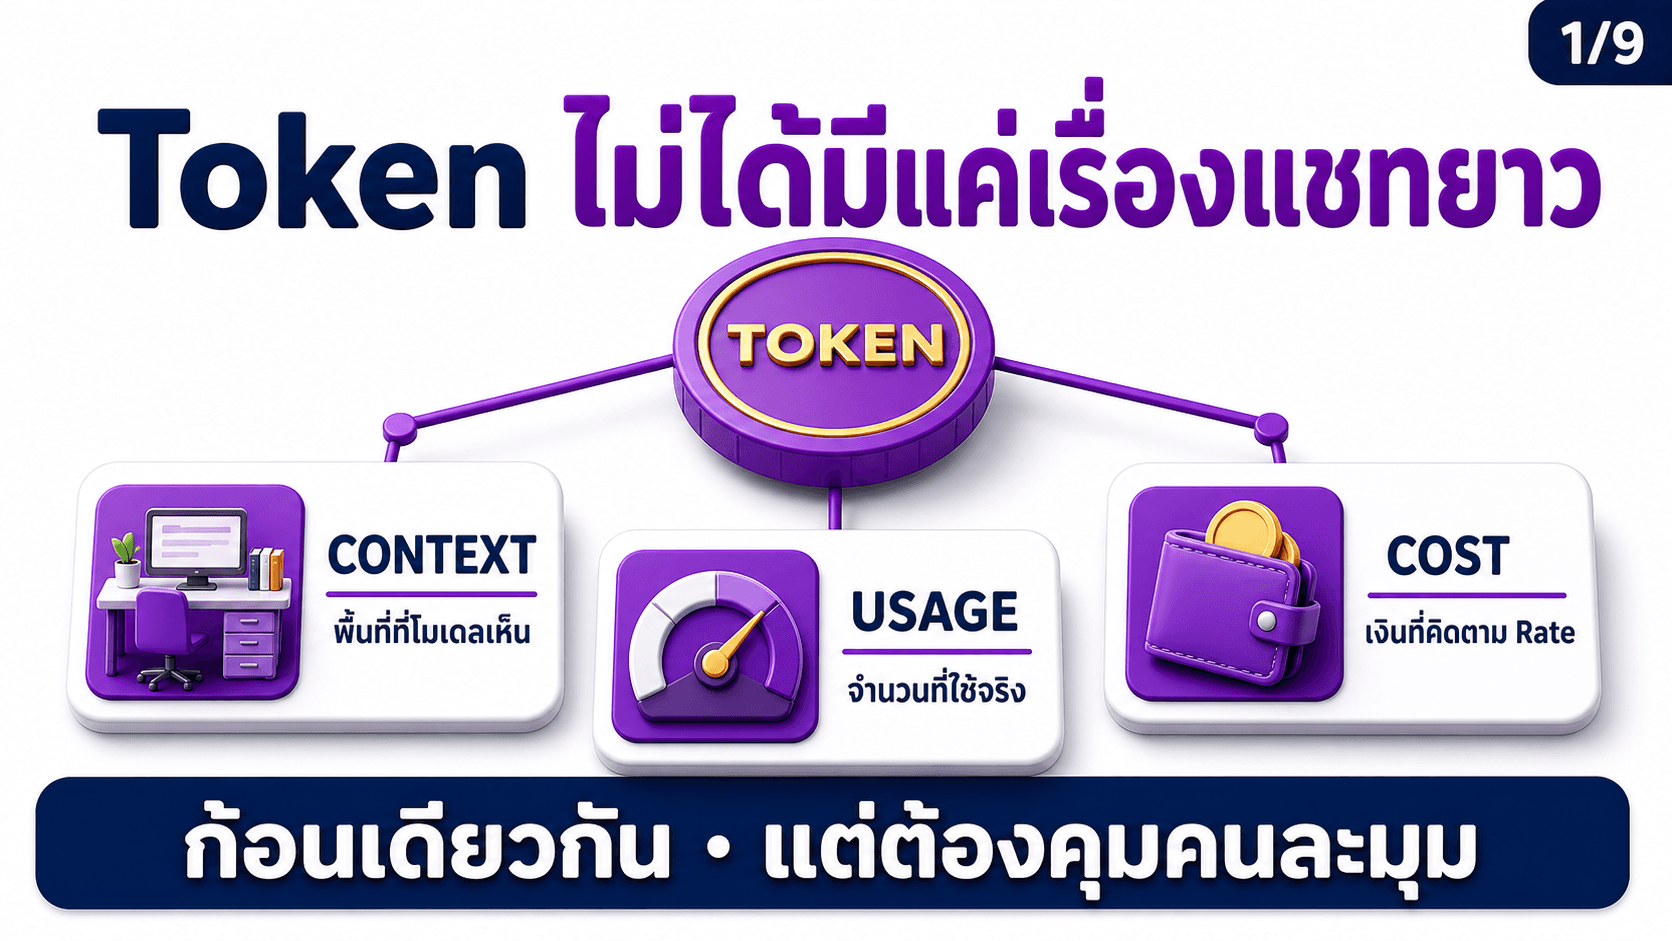
Token ก้อนเดียวไปกระทบสามเรื่องพร้อมกัน
1. Context — ข้อความ ไฟล์ Tool definitions และประวัติที่โมเดลมองเห็นตอนสร้างคำตอบ 2. Usage — จำนวน Input, Output และส่วนที่เกี่ยวกับ Cache ซึ่ง Response รายงานกลับ 3. Cost — ค่าใช้จ่ายที่คำนวณจาก Usage แต่ละชนิดคูณ Rate ของ Provider และ Model
เอกสาร Claude อธิบายว่า Context Window คือข้อความทั้งหมดที่โมเดลอ้างอิงได้ขณะสร้างคำตอบ และ Context ที่มากขึ้นไม่ได้แปลว่าดีกว่าอัตโนมัติ.[2] ตารางราคาทางการของ Claude และ OpenAI แยกหมวด Input, Cache และ Output ออกจากกัน.[6][7]
จึงต้องเลิกถามเพียงว่า “เหลือ Context เท่าไร” แล้วเพิ่มอีกสองคำถาม
- Request นี้ใช้ Token อะไรไปบ้าง
- คุณภาพที่ได้คุ้มกับต้นทุนหรือไม่
ก้อนเดียวกัน · แต่ต้องคุมคนละมุม
สไลด์ 2 — ศัพท์ 5 คำที่ต้องรู้
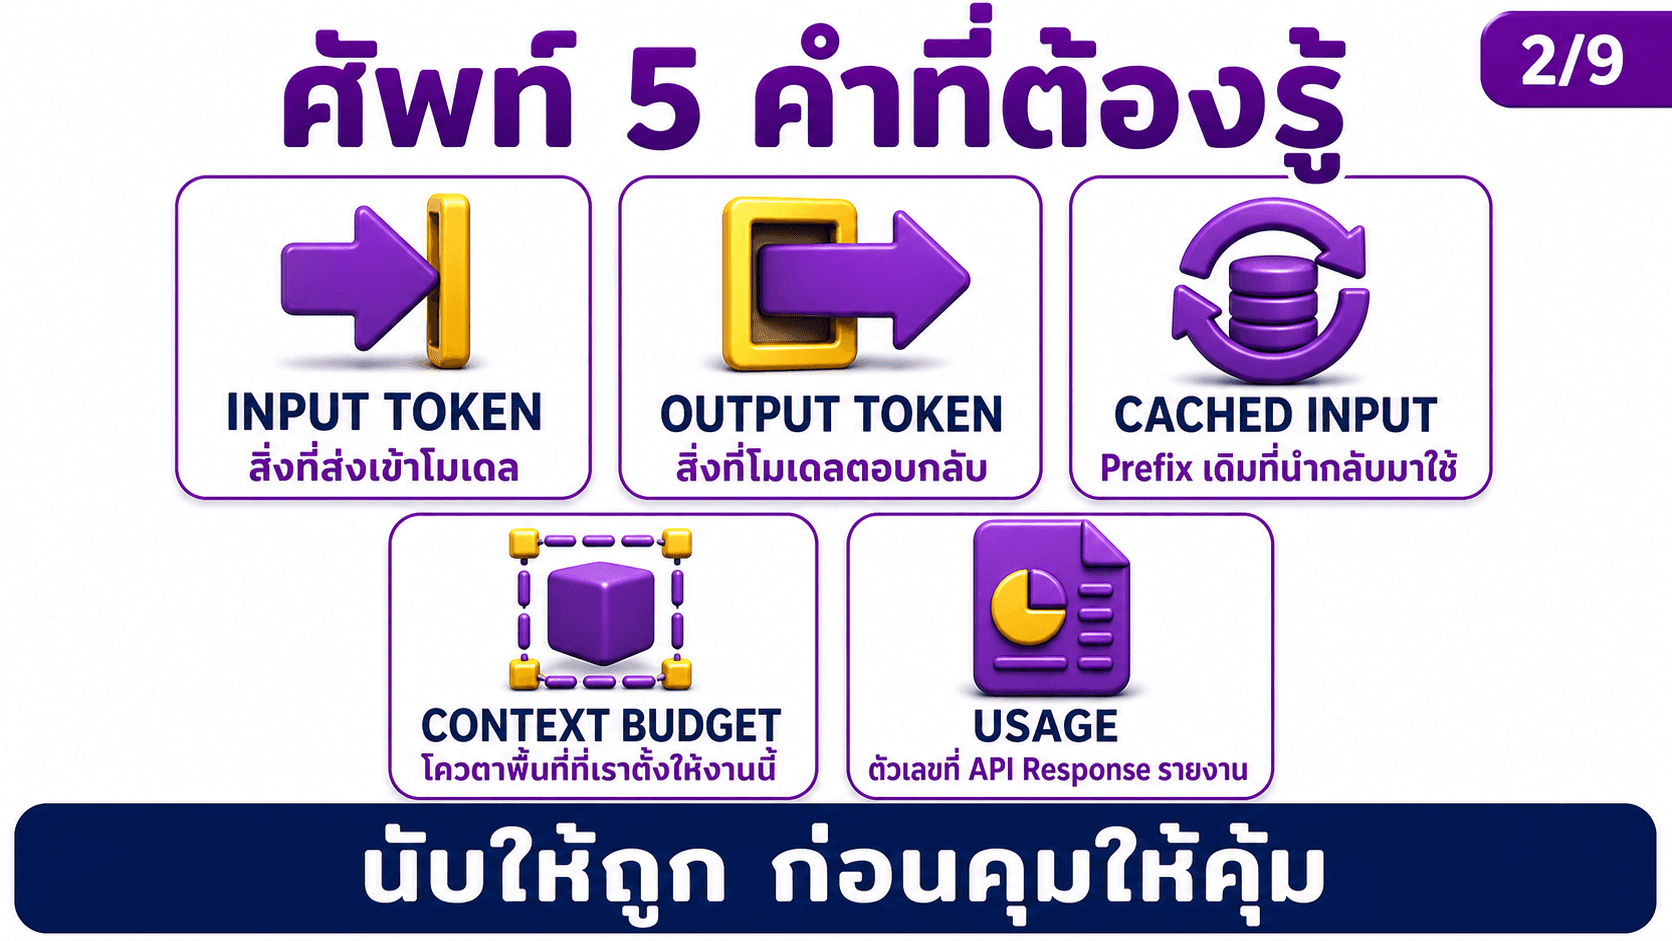
- Input Token — ทุกอย่างที่ส่งเข้าโมเดล เช่น Instruction, ประวัติ, Tool schema, ไฟล์ และโจทย์รอบนี้
- Output Token — ข้อความหรือข้อมูลที่โมเดลสร้างกลับมา รวมส่วนประกอบที่ Provider นับเป็น Output ตามเอกสารของตน
- Cached Input — ส่วนของ Prompt Prefix ที่ระบบนำผลการประมวลผลเดิมกลับมาใช้เมื่อเงื่อนไขตรง
- Context Budget — โควตาพื้นที่ที่เราตั้งใจจัดสรรให้งาน ไม่ใช่เพดานสูงสุดที่ Model รองรับ และไม่ใช่ชื่อ Field มาตรฐานที่ทุก API มี
- Usage — ตัวเลขที่ API Response รายงาน เช่น Input, Output, Total และรายละเอียด Cache ตามที่ API นั้นรองรับ
OpenAI Responses API ระบุ Usage ด้วย Input tokens, Output tokens, Total tokens และรายละเอียด Input ซึ่งอาจมี Cached tokens.[5] ฝั่ง Claude แยก Input, Cache read และ Cache creation ใน Usage เมื่อใช้ Prompt caching.[2]
คำว่า “Token ทั้งหมด” จึงไม่พอสำหรับวิเคราะห์ต้นทุน เพราะเราต้องรู้ว่ามาจากหมวดไหน
นับให้ถูก ก่อนคุมให้คุ้ม
สไลด์ 3 — Context Budget ไม่ใช่ Money Budget
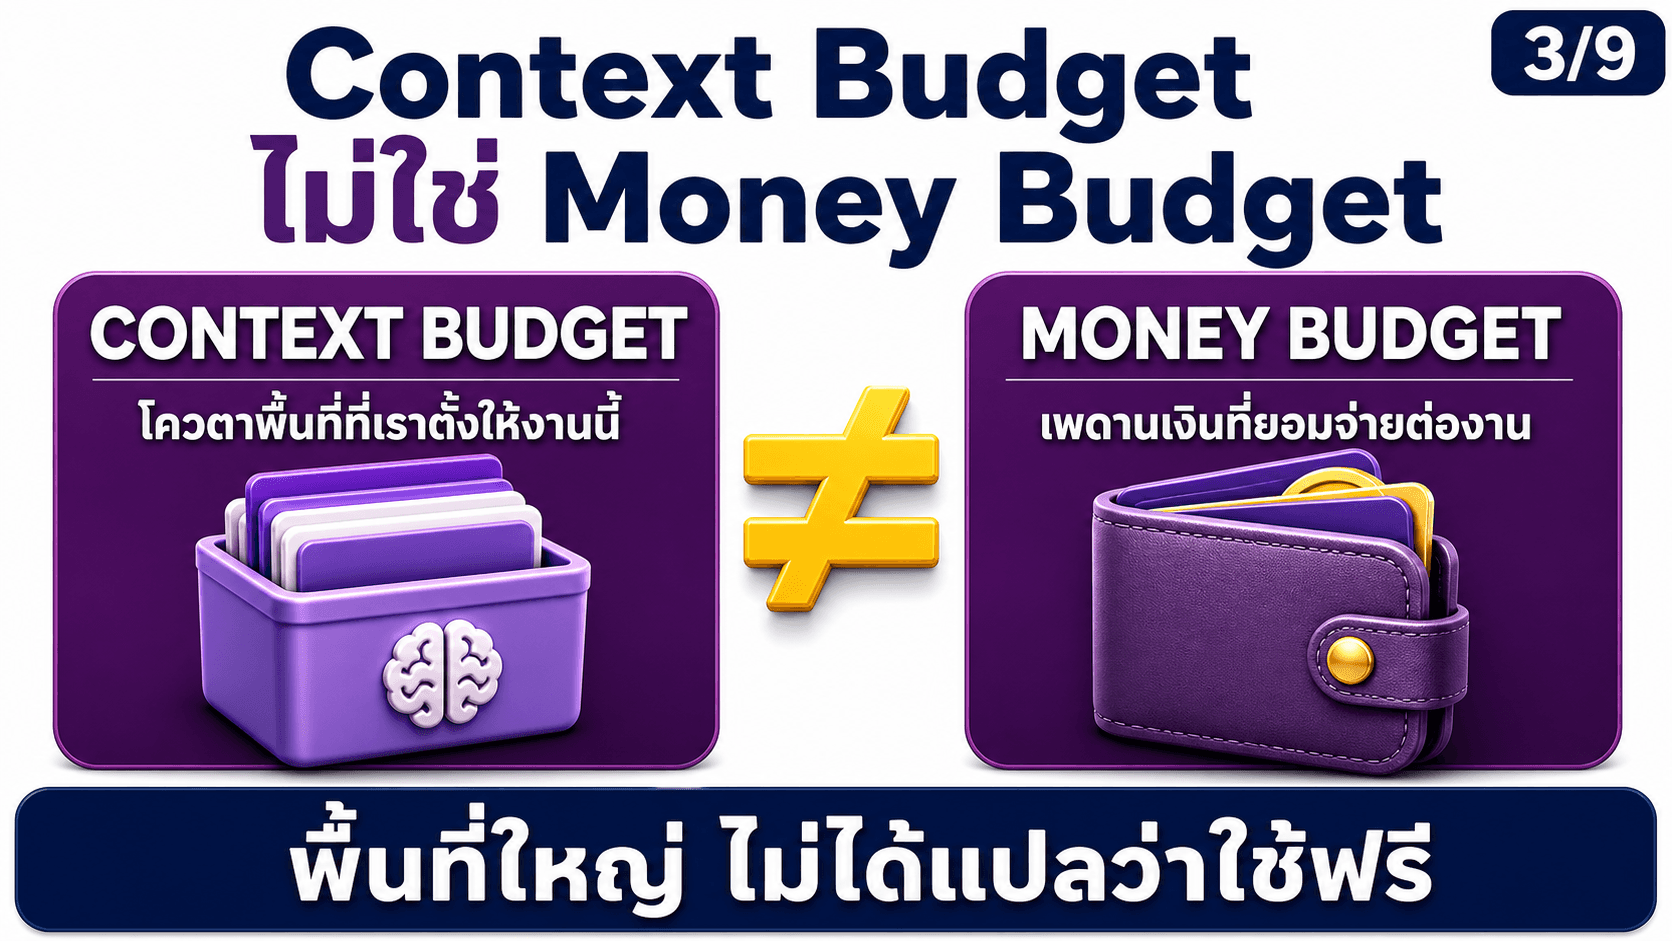
สอง Budget นี้เกี่ยวกัน แต่ไม่ใช่สิ่งเดียวกัน
Context Budget
ตอบคำถามว่า เราตั้งโควตาพื้นที่ให้ข้อมูลและคำตอบของงานรอบนี้เท่าไร คำว่า Context Budget เป็นคำวางแผนที่ใช้ในบทนี้ ไม่ใช่ชื่อ Field มาตรฐานที่ทุก API มี ถ้าใส่ Input มากเกินไป พื้นที่สำหรับ Output อาจไม่พอ หรือ Request อาจชนข้อจำกัดของ Model
Money Budget
ตอบคำถามว่า ตั้งเพดานเงินที่ยอมจ่ายต่อ Task, ต่อวัน หรือต่อ Project เท่าไร ส่วน Cost คือค่าใช้จ่ายที่เกิดขึ้นจริงจาก Usage และ Rate ของแต่ละหมวด
ในการคุยหลายเทิร์น ประวัติ User และ Assistant จะสะสมอยู่ใน Context ของ Request ถัดไป และ Output รอบนี้จะกลายเป็นส่วนหนึ่งของ Input รอบหน้า.[2] นี่คือเหตุผลที่งานเดิมอาจมี Input โตขึ้นเรื่อย ๆ แม้โจทย์ใหม่จะสั้น
แต่ Context ใหญ่ไม่ได้แปลว่าควรใช้ให้เต็มเสมอ เอกสาร Claude เตือนว่าการมี Context มากขึ้นไม่ได้ดีขึ้นอัตโนมัติ และการคัดสิ่งที่อยู่ใน Context สำคัญพอ ๆ กับขนาดพื้นที่.[2]
พื้นที่ใหญ่ ไม่ได้แปลว่าใช้ฟรี
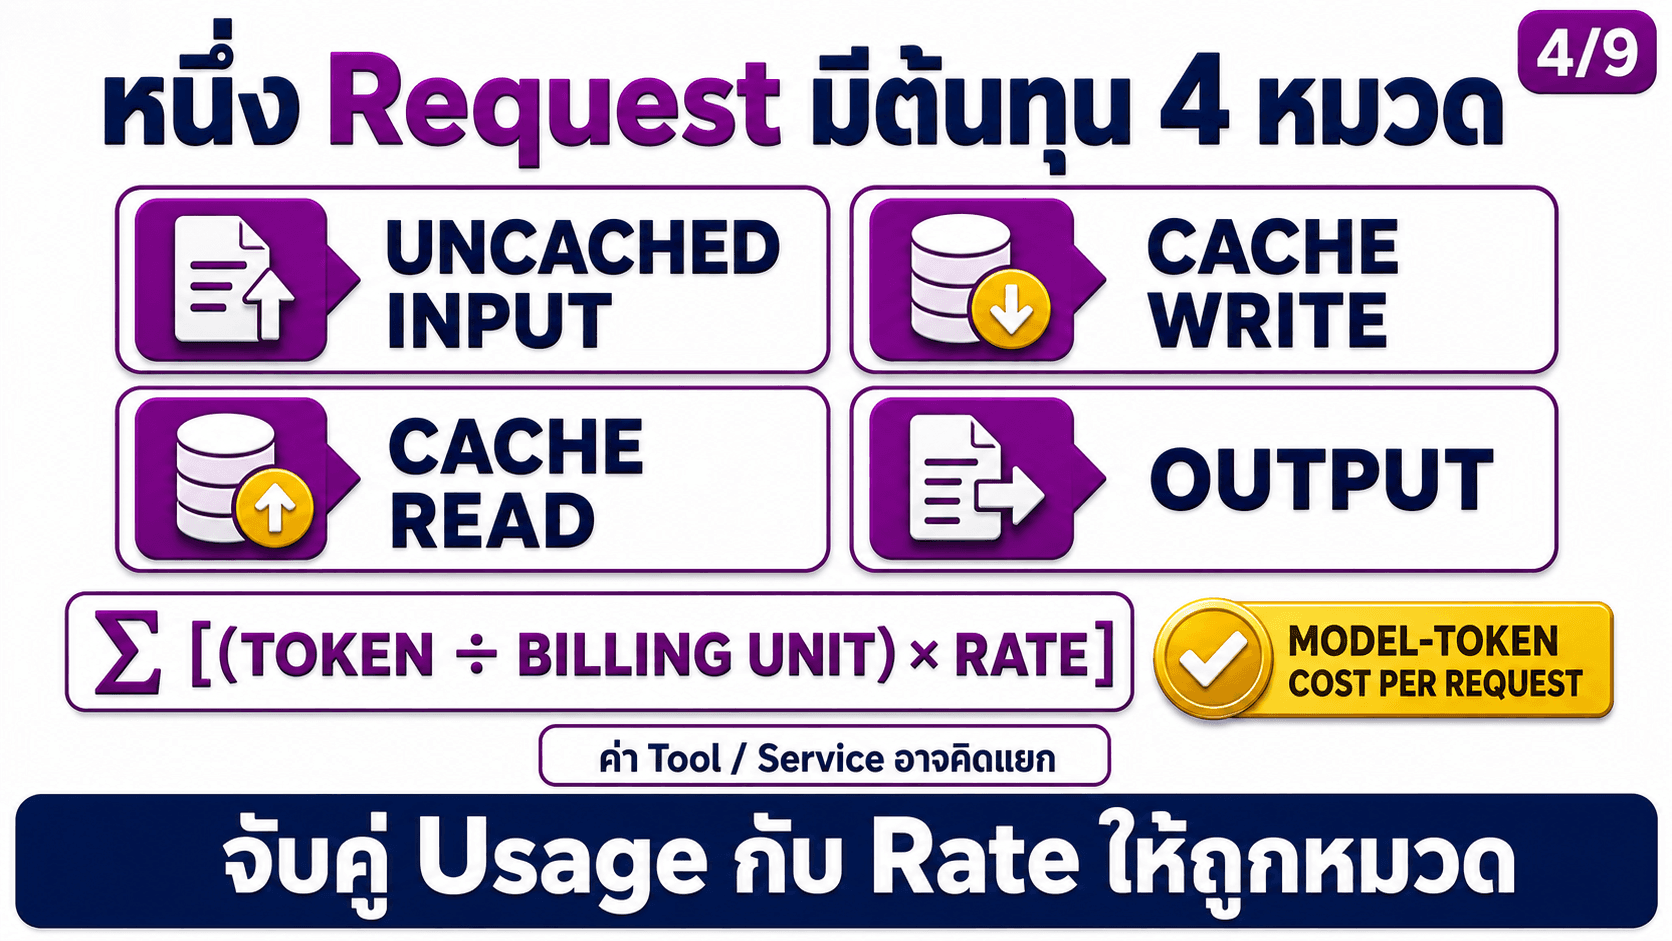
สไลด์ 4 — หนึ่ง Request มีต้นทุน 4 หมวด
ให้แยก Model-token cost เป็นสี่หมวดก่อนรวม
1. Uncached Input — Token ใหม่ที่ต้องประมวลผล 2. Cache Write — Token ที่เขียนเข้า Cache 3. Cache Read — Token ที่นำกลับมาจาก Cache 4. Output — Token ที่โมเดลสร้างกลับ
สูตรทั่วไปต่อหนึ่ง Request คือ
MODEL-TOKEN COST PER REQUEST
= Σ [(Token ของแต่ละหมวด ÷ Billing unit) × Rate ทางการ]
Billing unit ต้องตรงกับหน้า Pricing เช่น Rate ที่ประกาศต่อ MTok หรือต่อหนึ่งล้าน Token ต้องหาร Usage ด้วยหน่วยเดียวกันก่อนคูณ ตารางราคาทางการของ Claude แยก Base input, Cache write, Cache hit และ Output ส่วน OpenAI แยก Input, Cached input, Cache write และ Output ตาม Model/Service tier.[6][7]
ต้องจับคู่ Usage field กับ Billing category ตามเอกสารของ Provider ห้ามถือว่าช่องที่ไม่แสดงใน Response มีค่าเป็นศูนย์ และสูตรนี้คิดเฉพาะค่า Model Token; ค่า Tool, Search, Storage หรือ Service อื่นอาจคิดแยก.[6][7]
Token cost per Task คือผลรวม Model-token cost ของทุก Request และ Retry ใน Task เดียวกัน ไม่ใช่เฉพาะ Request ที่สำเร็จ
Rate เปลี่ยนตามเวลา Model, Context tier, Service tier และ Provider จึงควรดึง Rate ล่าสุดจากหน้า Pricing ทางการตอนคำนวณ ไม่ควรฝังตัวเลขไว้ใน Prompt, Slide หรือ Code ที่ไม่มีระบบอัปเดต
จับคู่ Usage กับ Rate ให้ถูกหมวด
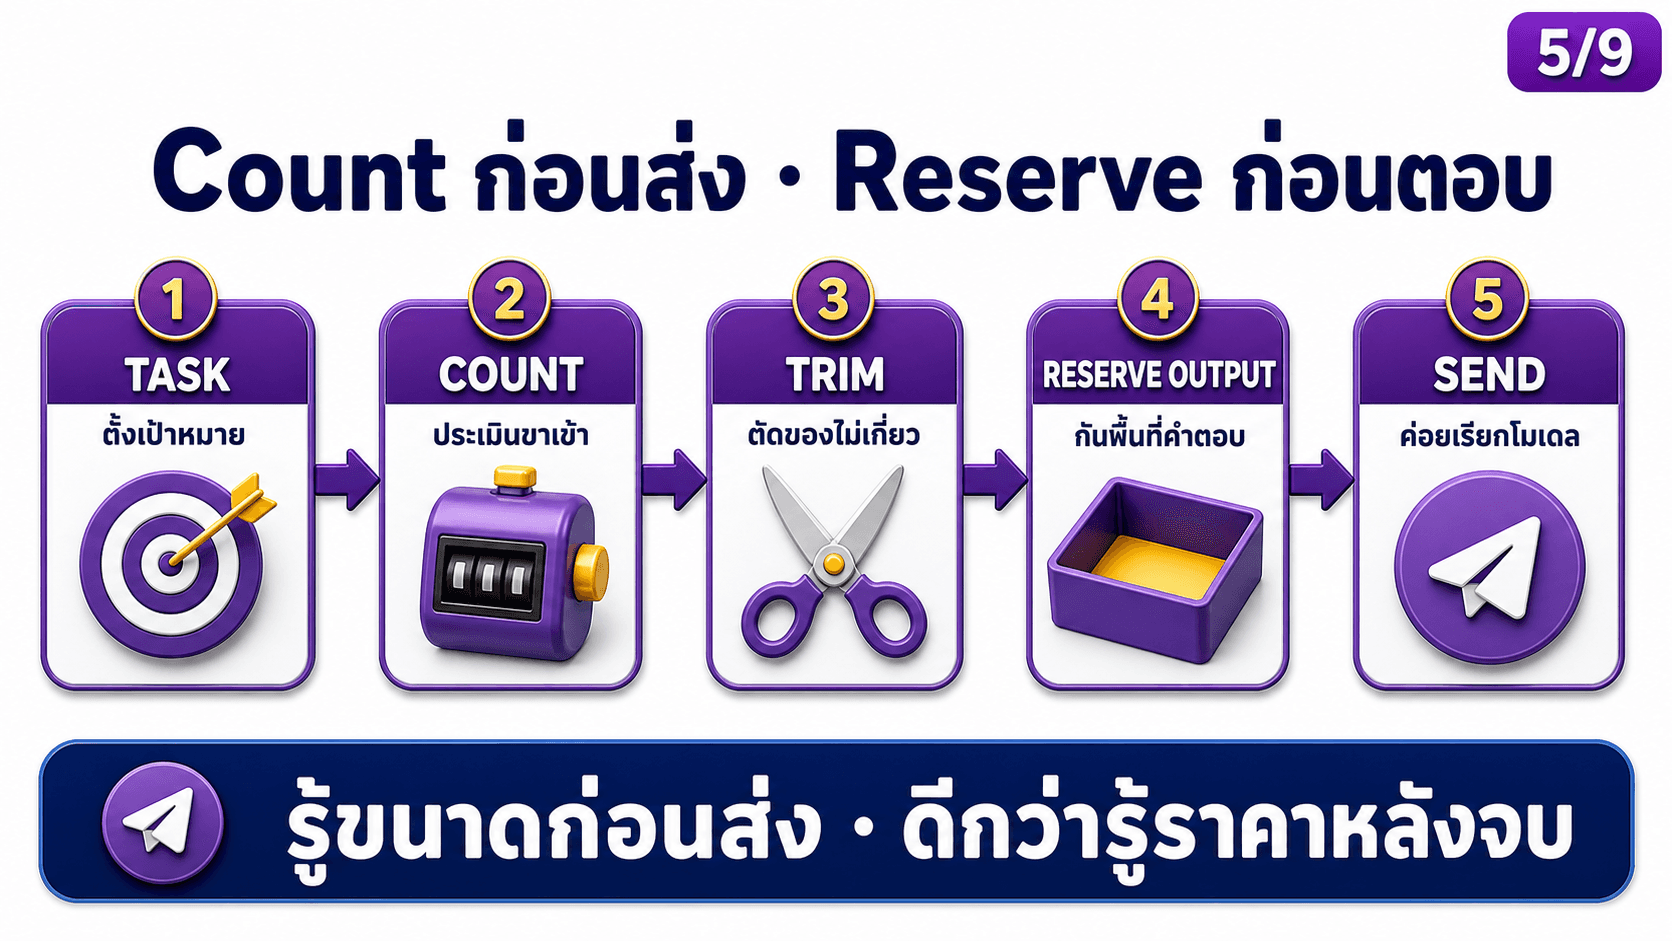
สไลด์ 5 — Count ก่อนส่ง · Reserve ก่อนตอบ
ก่อนเรียกโมเดล ให้ทำห้าจังหวะ
1. Task — ล็อกผลลัพธ์ที่ต้องการ 2. Count — ประเมิน Input ทั้งข้อความ ไฟล์ Tools และ System instructions 3. Trim — ตัดข้อมูลที่ไม่เกี่ยว ไม่ใช่ตัดหลักฐานสำคัญ 4. Reserve Output — กันพื้นที่ให้คำตอบตามรูปแบบที่ต้องการ 5. Send — เรียกโมเดลเมื่อขนาดอยู่ใน Budget
Claude มี Token counting endpoint สำหรับประเมินจำนวน Input ก่อนส่ง Request เพื่อช่วยจัดการ Cost, Rate limit และความยาว Prompt.[1] เอกสารระบุด้วยว่าค่าที่นับเป็น Estimate และ Usage จริงอาจต่างเล็กน้อย.[1]
ดังนั้น Token count ก่อนส่งคือเครื่องมือวางแผน ไม่ใช่ใบแจ้งหนี้สุดท้าย หลัง Response กลับมายังต้องอ่าน Usage จริงอีกครั้ง
ตัวอย่าง: ถ้าจะสรุปยอดขายเดือนนี้ อย่าส่งรายงานทุกปีเพราะ “เผื่อใช้” ให้ส่ง Schema, นิยาม Metric และข้อมูลเดือนที่วิเคราะห์จริง ส่วนข้อมูลเก่าดึงมาเพิ่มเมื่อมีคำถามที่ต้องเทียบ
รู้ขนาดก่อนส่ง · ดีกว่ารู้ราคาหลังจบ
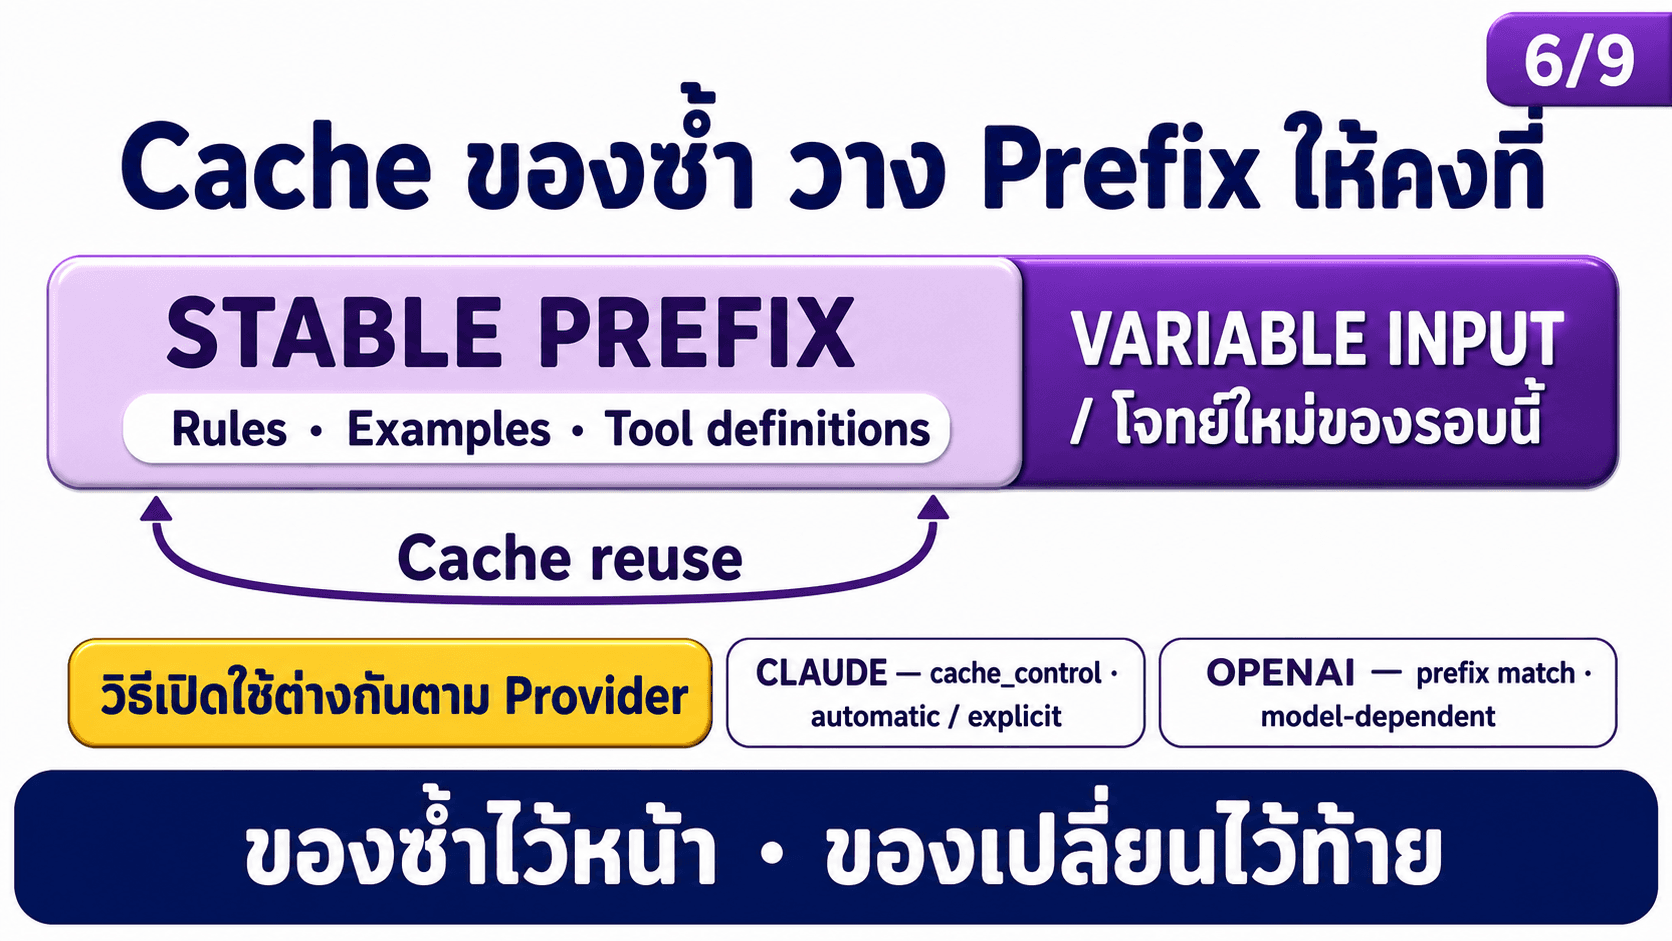
สไลด์ 6 — Cache ของซ้ำ วาง Prefix ให้คงที่
Prompt caching เหมาะกับส่วนที่ยาวและใช้ซ้ำ เช่น
- System instructions
- Brand rules หรือ Policy
- ตัวอย่างคำตอบที่ดี
- Tool definitions
- เอกสารอ้างอิงชุดเดิม
แนวคิดคือวาง Stable Prefix ไว้ด้านหน้า แล้ววาง Variable Input หรือโจทย์ใหม่ไว้ด้านท้าย Request ที่ตามมาจึงมีโอกาสนำ Prefix เดิมกลับมาใช้
Claude รองรับ Prompt caching ผ่าน Automatic caching หรือ Explicit cache breakpoints และใช้ Cache control ตามรูปแบบของ Claude.[3] OpenAI รองรับ Prompt caching สำหรับ Model ที่กำหนด โดยการใช้ซ้ำต้องมี Rendered prefix ที่ตรงกัน และพฤติกรรม Breakpoint ขึ้นกับ Model.[4]
จำป้ายสั้นไว้ว่า CLAUDE — cache_control · automatic / explicit และ OPENAI — prefix match · model-dependent รายละเอียดจริงต้องอ่านจากเอกสารของ Provider และ Model ที่ใช้
จึงห้ามเขียนคู่มือว่า “เปิด Cache แบบนี้ใช้ได้ทุกเจ้า” สิ่งที่ใช้ร่วมกันได้คือหลัก ของซ้ำไว้หน้า ของเปลี่ยนไว้ท้าย ส่วนวิธีเปิดใช้ อายุ Cache และ Rate ต้องอ่านจาก Provider ปัจจุบัน
Cache ไม่ได้แปลว่าฟรี ตาราง Pricing ยังแยก Cached input, Cache write หรือ Cache hit ตามระบบของแต่ละ Provider.[6][7]
ของซ้ำไว้หน้า · ของเปลี่ยนไว้ท้าย
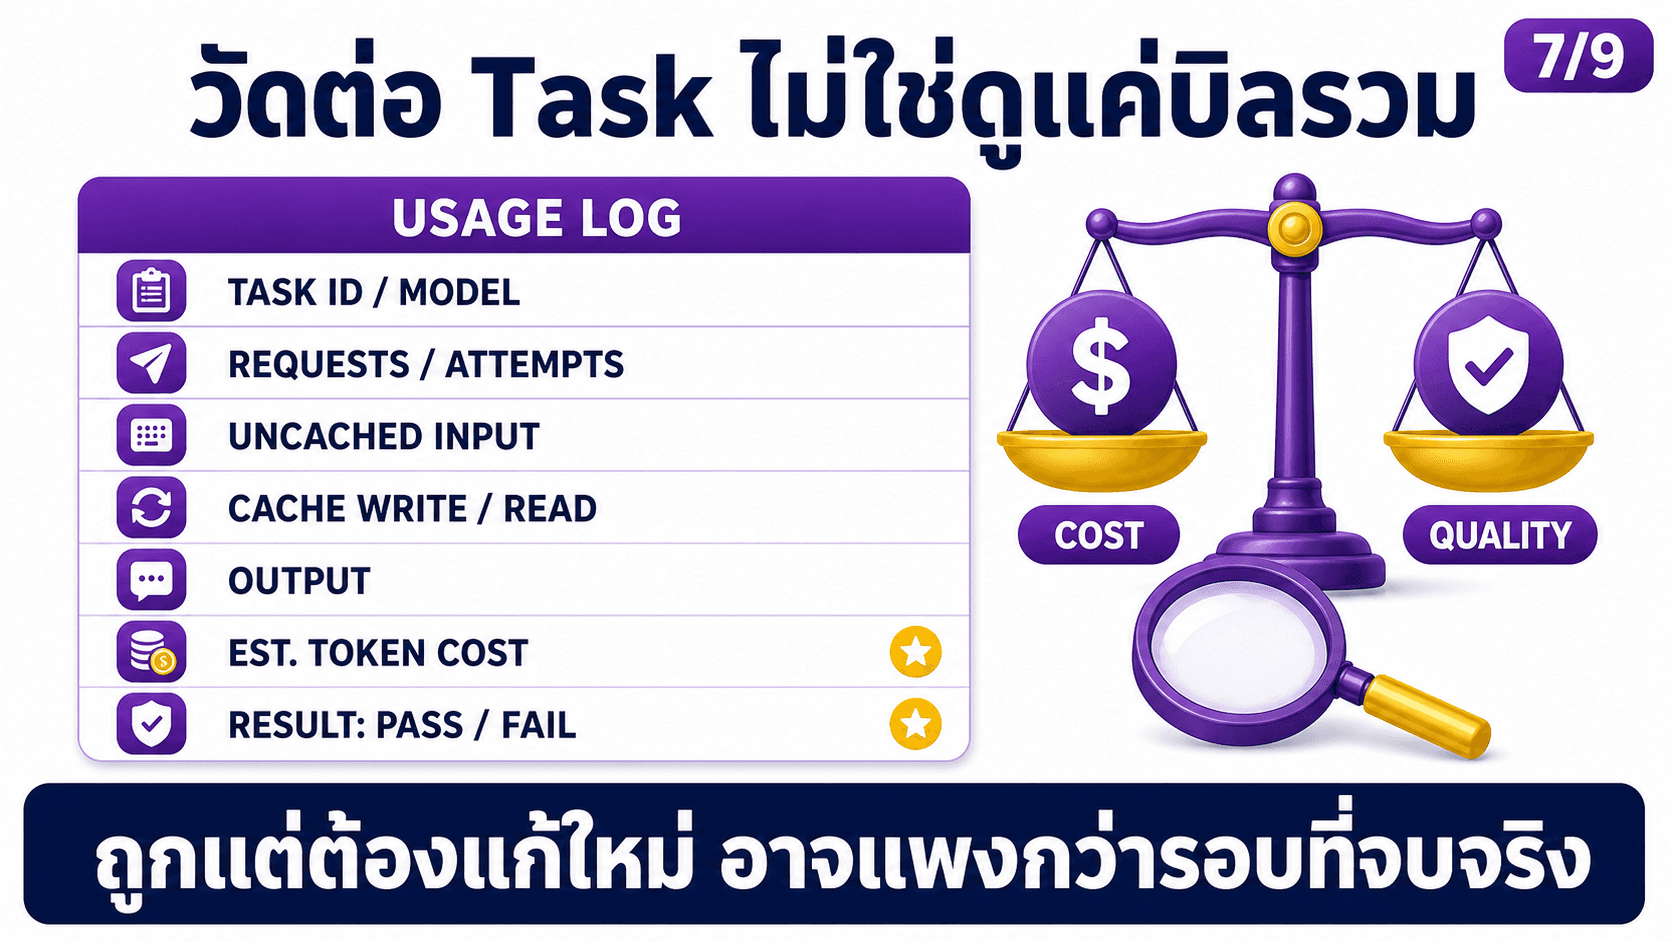
สไลด์ 7 — วัดต่อ Task ไม่ใช่ดูแค่บิลรวม
ยอดรวมรายเดือนบอกว่าใช้เงินเท่าไร แต่ยังไม่บอกว่า งานไหนคุ้ม
ให้เก็บ Usage Log ต่อ Task อย่างน้อย
Task ID / Model
Requests / Attempts
Uncached input tokens
Cache write / read tokens
Output tokens
Estimated model-token cost
Result: PASS / FAIL
Artifact or URL
OpenAI Responses API มี Usage ที่รายงาน Input, Output, Total และรายละเอียด Cache.[5] เอกสาร Claude ระบุว่า Response รายงานสิ่งที่ Request ใช้ผ่าน Usage field และเมื่อใช้ Prompt caching จะแยกตัวเลข Cache เพิ่ม.[2]
เมื่อมี Log เราจะตอบได้ว่า
- งานไหน Input ใหญ่เพราะ Context ไม่เกี่ยว
- งานไหน Cache hit ต่ำเพราะ Prefix เปลี่ยนทุกครั้ง
- งานไหน Output ยาวแต่ไม่ได้เพิ่มคุณค่า
- งานไหนใช้รุ่นราคาต่ำแต่ Fail ซ้ำหลายรอบ
Failed attempt และ Retry ต้องรวมอยู่ในต้นทุนของ Task เดิม ต้นทุนที่ควรเทียบจึงเป็น Cost per PASS ไม่ใช่ Cost ต่อ Request ที่ดูถูกที่สุด
Cost per PASS
= Token cost รวมของทุก Attempt
  ÷ จำนวน Task ที่ผ่าน Quality Gate
ถูกแต่ต้องแก้ใหม่ อาจแพงกว่ารอบที่จบจริง
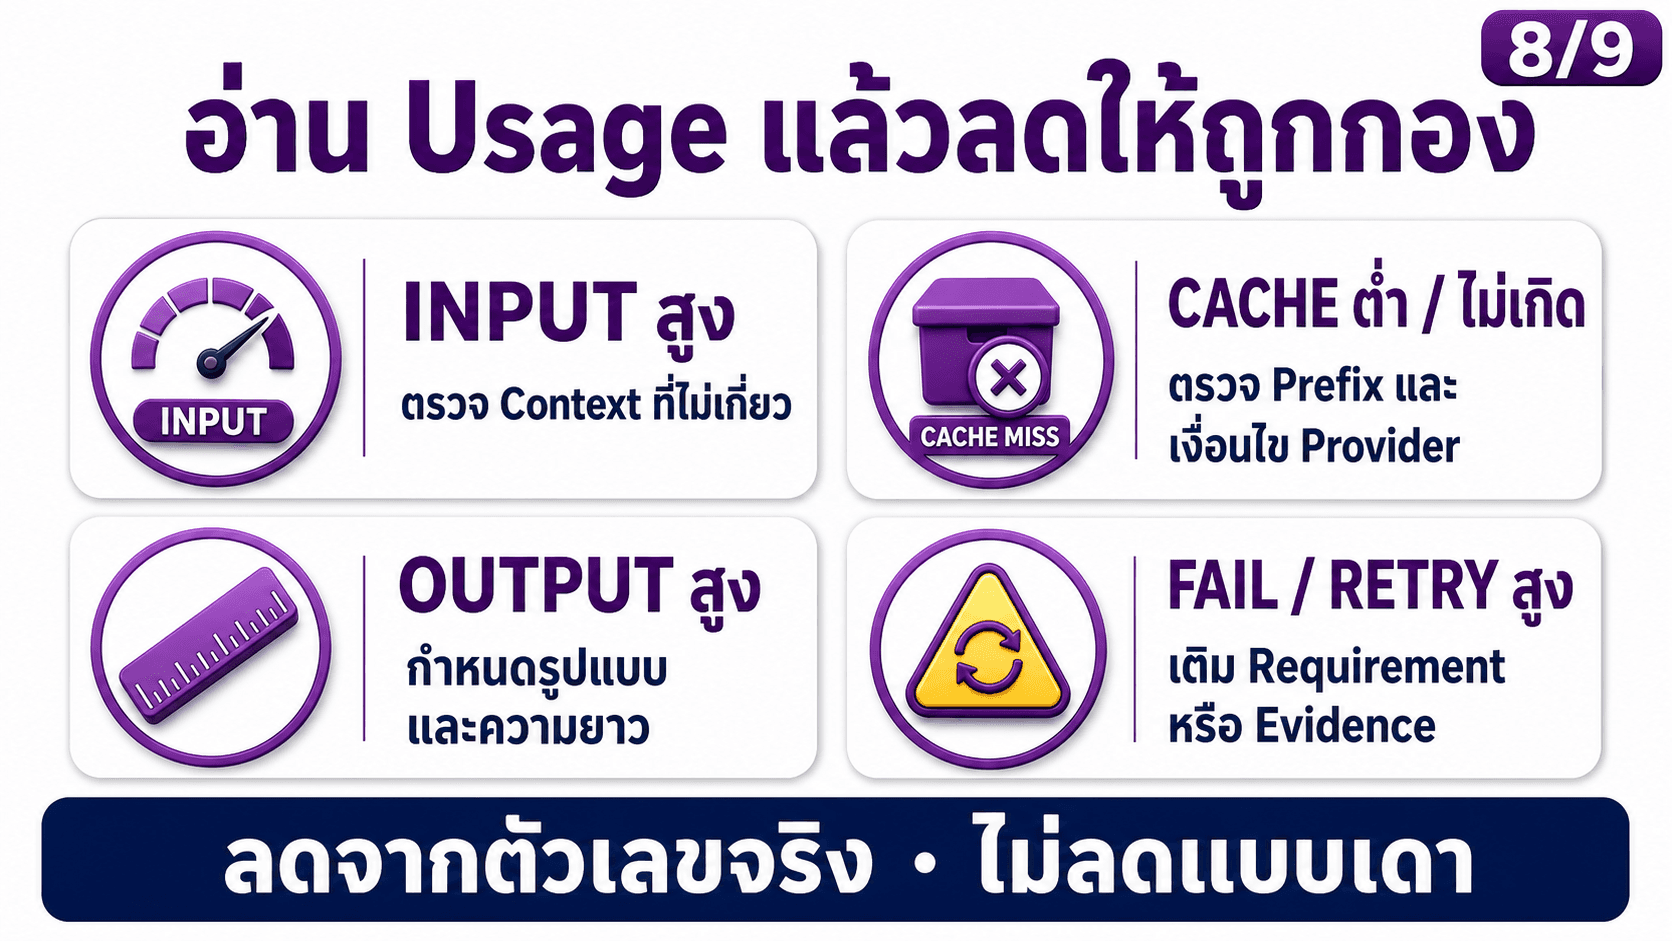
สไลด์ 8 — อ่าน Usage แล้วลดให้ถูกกอง
อย่าลด Token แบบเดา ให้ดู Usage และผลลัพธ์ก่อนว่าเกิดปัญหาที่กองใด
- Input สูง — ตรวจ Context ที่ไม่เกี่ยว แล้วค่อยกลับไปใช้หลักจาก บทที่ 3 เรื่องส่งเฉพาะข้อมูลที่จำเป็น
- Cache ต่ำหรือไม่เกิด — ตรวจว่า Prefix เปลี่ยนหรือเงื่อนไข Provider/Model ไม่ตรง
- Output สูง — กำหนด Format, ความยาว และ Stop condition ให้ชัด
- Fail / Retry สูง — อย่ารีบตัด Context ให้เติม Requirement, Evidence หรือ Tool ที่ขาด
ถ้างานยาวจนต้องย่อหรือส่งต่อ ให้ใช้ Compact/Clear/Handoff ตาม บทที่ 29 แทนการสอนซ้ำในบทนี้
ลดจากตัวเลขจริง · ไม่ลดแบบเดา
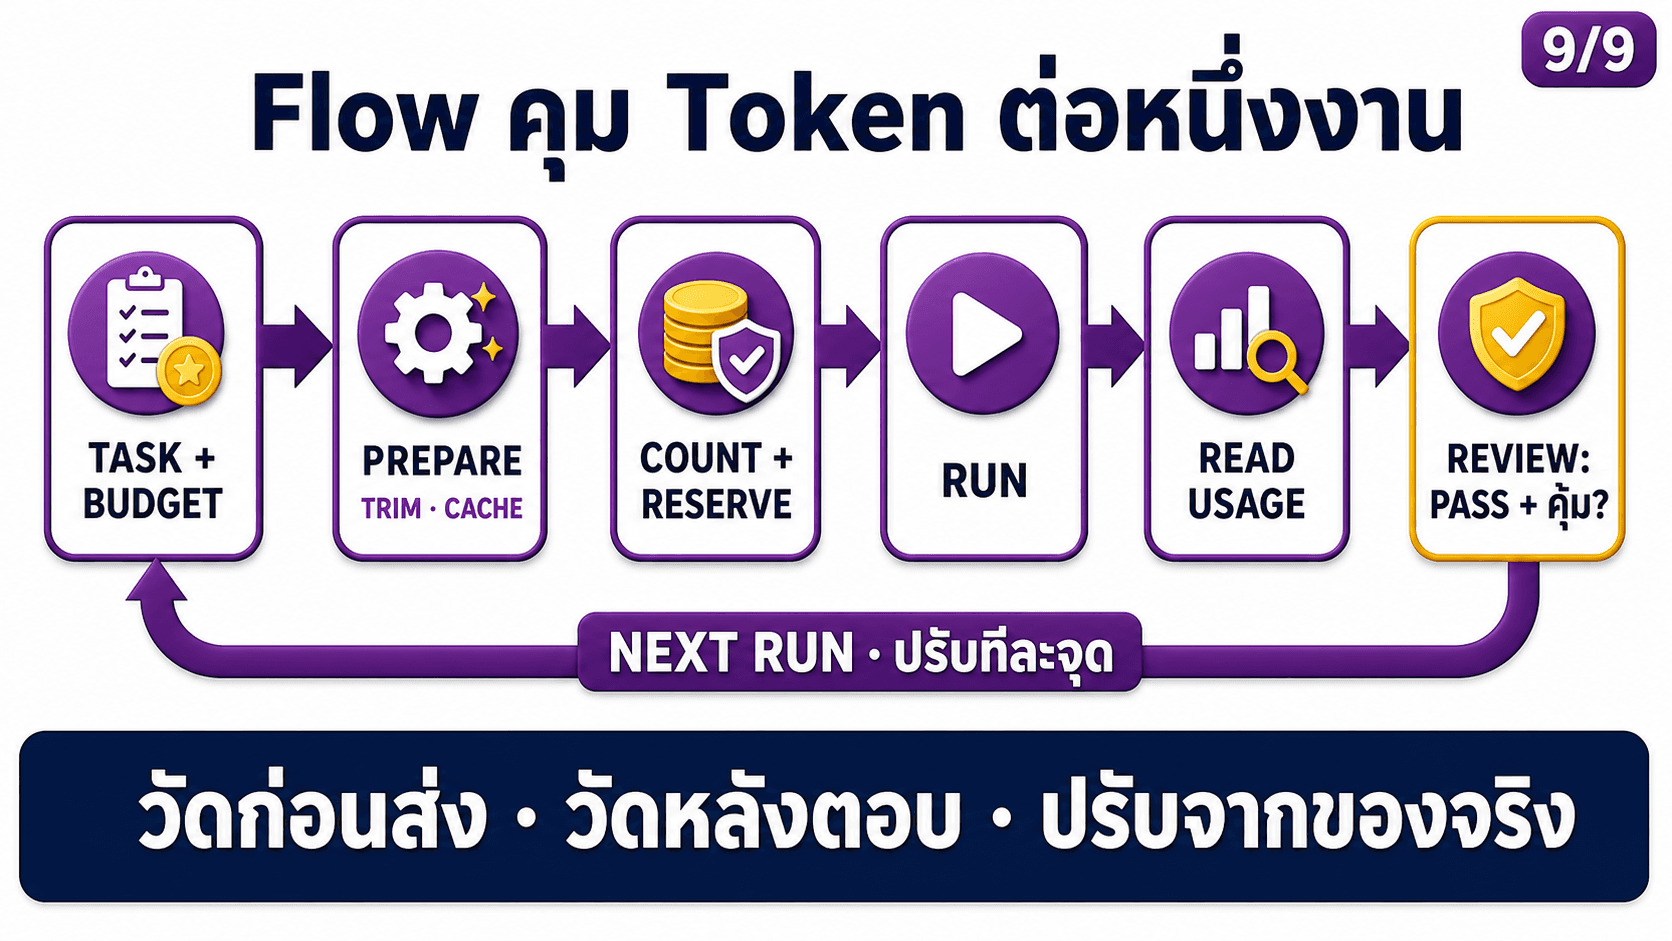
สไลด์ 9 — Flow คุม Token ต่อหนึ่งงาน
ใช้ Flow เดียวกันกับทุก Task ที่เรียก AI ผ่าน API หรือ Agent
TASK + BUDGET
→ PREPARE (TRIM · CACHE)
→ COUNT + RESERVE
→ RUN
→ READ USAGE
→ REVIEW: PASS + คุ้ม?
↺ NEXT RUN · ปรับทีละจุด — กลับไป TASK + BUDGET
Review ต้องผ่านสองคำถามพร้อมกัน
1. Quality pass หรือไม่ — ผลลัพธ์ผ่าน Definition of Done และ Verification หรือยัง 2. Cost acceptable หรือไม่ — ต้นทุนต่อผลลัพธ์อยู่ใน Budget ที่ธุรกิจรับได้หรือไม่
ถ้าคุณภาพไม่ผ่าน ให้แก้ Requirement/Evidence แล้ว Retry ใน Task เดิม ถ้าผ่านแต่แพง ให้ลดจาก Usage ทีละกอง ถ้าผ่านและคุ้ม ให้นำข้อมูลนี้ไปตั้ง Budget ของรอบถัดไป ลูกศรจึงกลับไปที่ TASK + BUDGET เดิม ไม่ใช่ข้ามไปงานใหม่โดยอัตโนมัติ
ลองทำเลย
เลือกงาน AI ที่รันซ้ำหนึ่งงาน แล้วเก็บ Log อย่างน้อยห้ารอบ
Task: <ชื่องาน>
Requests / Attempts: <จำนวนจริง>
Uncached input: <usage จริง>
Cache write / read: <จับคู่จากเอกสาร Provider>
Output: <usage จริง>
Est. model-token cost: <คำนวณจาก Rate ทางการล่าสุด>
Result: PASS / FAIL
สิ่งที่จะปรับรอบหน้า: <หนึ่งอย่างเท่านั้น>
หลังห้ารอบ ให้เปรียบเทียบ Cost ต่อ PASS ไม่ใช่ดูรอบที่ Token ต่ำที่สุด แล้วเลือกปรับทีละจุดเพื่อรู้ว่าอะไรสร้างผลจริง
วัดก่อนส่ง · วัดหลังตอบ · ปรับจากของจริง
เช็คลิสต์ท้ายบท
- แยก Context Budget ออกจาก Money Budget ได้
- รู้ว่า Input, Cache และ Output อาจมี Rate ต่างกัน
- Count หรือ Estimate Input ก่อนส่งงานใหญ่
- ใช้ Prefix คงที่เฉพาะเมื่อ Provider/Model รองรับ Prompt caching
- อ่าน Usage จริงหลัง Response ไม่ใช้ค่าประเมินแทน
- เก็บ Cost และ Result ต่อ Task
- ตัดเฉพาะ Context ที่ไม่เกี่ยว ไม่ตัด Requirement หรือ Evidence
- ใช้ Rate ล่าสุดจาก Pricing ทางการ ไม่ฝังราคาตายตัว
Sources
[1] https://platform.claude.com/docs/en/build-with-claude/token-counting — Claude Platform — Token counting [2] https://platform.claude.com/docs/en/build-with-claude/context-windows — Claude Platform — Context windows [3] https://platform.claude.com/docs/en/build-with-claude/prompt-caching — Claude Platform — Prompt caching [4] https://developers.openai.com/api/docs/guides/prompt-caching — OpenAI API — Prompt caching [5] https://developers.openai.com/api/reference/resources/responses — OpenAI API — Responses usage [6] https://platform.claude.com/docs/en/about-claude/pricing — Claude Platform — Pricing [7] https://developers.openai.com/api/docs/pricing — OpenAI API — Pricing